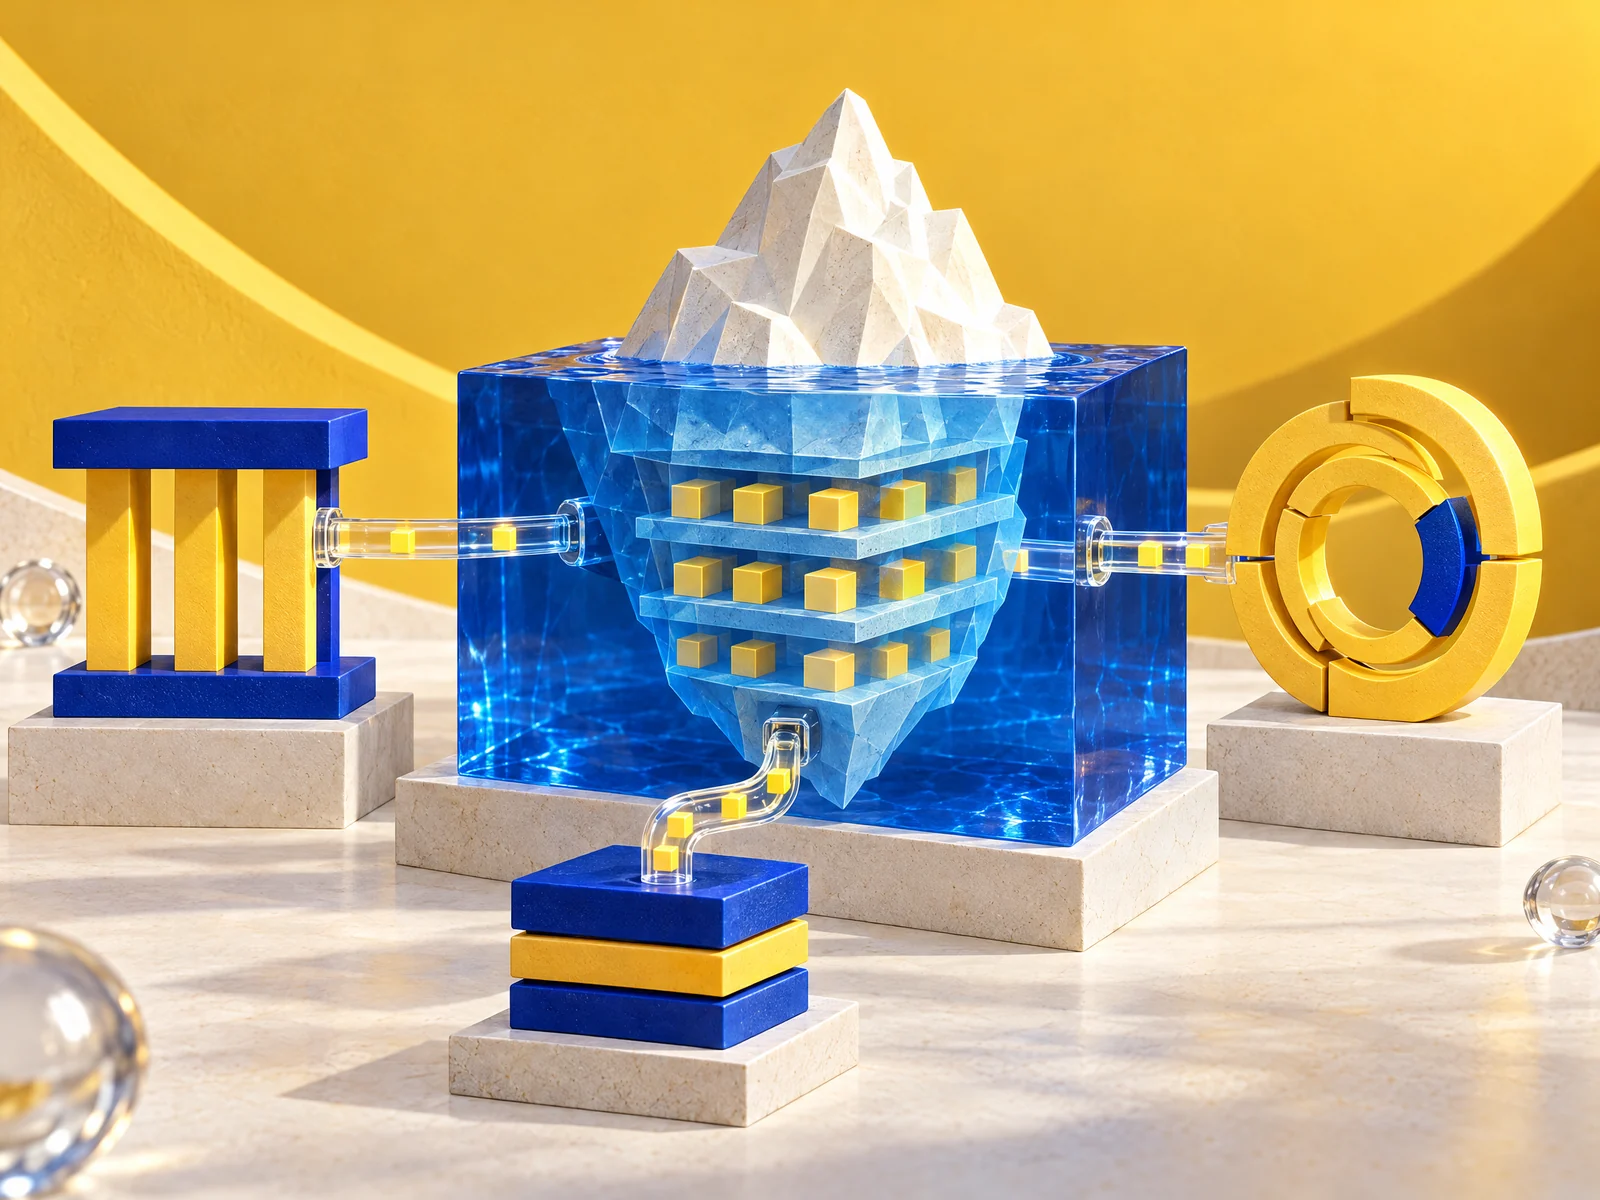
Apache Iceberg s'impose parce qu'il résout un problème que les moteurs propriétaires avaient transformé en dépendance : une table n'appartient plus au moteur qui l'a créée. Sa spécification décrit précisément comment représenter une table analytique sur des fichiers immuables, de sorte que Spark, Trino, Flink, un entrepôt cloud ou un service géré puissent la lire et l'écrire de manière cohérente. Ajoutez un protocole de catalogue standardisé en REST, et la table devient un actif partagé plutôt qu'un format captif.
Les éditeurs ont suivi. Snowflake annonce la disponibilité générale du support d'Iceberg version 3 depuis le 7 mai 2026 6, AWS stocke ses S3 Tables au format Iceberg avec support de la version 3 7, et Apache Polaris, implémentation ouverte du catalogue REST Iceberg, est devenu projet de premier niveau de la fondation Apache le 19 février 2026 5.
Voici les quatre mécanismes qui expliquent cette adoption, et ce qu'il faut vérifier avant d'en faire le standard de votre plateforme.
Comment Apache Iceberg représente une table
Une table Iceberg est une arborescence de métadonnées au-dessus de fichiers de données (Parquet, Avro ou ORC). Chaque modification produit un nouveau fichier de métadonnées, qui pointe vers une liste de manifestes, qui eux-mêmes listent les fichiers de données et leurs statistiques. L'état de la table à un instant donné s'appelle un snapshot 1.
Le point clé est l'échange atomique : une écriture ne devient visible que lorsque le pointeur vers le nouveau fichier de métadonnées est remplacé. Les lecteurs utilisent le snapshot courant au moment où ils chargent la table, ils sont donc isolés des écritures concurrentes ; les écrivains fonctionnent en concurrence optimiste et réessaient si le snapshot de base a changé entre-temps 1. C'est ce qui permet à plusieurs moteurs de travailler sur la même table sans verrou global.
Évolution de schéma et de partitionnement sans réécriture
Dans un lac de données classique, renommer une colonne ou changer le partitionnement d'une table de plusieurs téraoctets était un chantier. Iceberg identifie chaque colonne par un identifiant unique, et non par son nom ou sa position. Ajouter, supprimer, renommer ou réordonner une colonne, ou élargir un type (par exemple d'entier vers entier long), sont des opérations sur les métadonnées seules, sans réécriture des fichiers 2.
Cet identifiant évite deux pièges connus : un format fondé sur les noms peut « ressusciter » une colonne supprimée si son nom est réutilisé, et un format fondé sur la position ne peut pas supprimer une colonne sans décaler les autres 2. Pour les équipes qui maintiennent des centaines de tables alimentées par des sources qui évoluent, c'est une source d'incidents en moins.
Le partitionnement suit la même logique. Les requêtes ne référencent pas directement les valeurs de partition : Iceberg dérive les filtres de partition à partir des prédicats sur les colonnes (partitionnement « caché »). On peut donc changer le schéma de partitionnement d'une table en place ; les anciennes données conservent leur ancien partitionnement, les nouvelles utilisent le nouveau, et le moteur planifie chaque partie avec le bon filtre 2. Même chose pour l'ordre de tri 2.
Avec Iceberg, une colonne est un identifiant, pas un nom : c'est ce détail qui rend l'évolution de schéma sûre.
Time travel, branches et tags : l'historique comme outil d'exploitation
Puisque chaque snapshot reste référencé jusqu'à son expiration, on peut interroger une table telle qu'elle était à une date ou à un snapshot donné. En Spark SQL, la syntaxe TIMESTAMP AS OF ou VERSION AS OF le permet, et VERSION AS OF accepte aussi le nom d'une branche ou d'un tag 3. Des tables de métadonnées (history, snapshots, files) exposent l'historique des commits, les opérations effectuées et les fichiers courants 3.
Les usages concrets dépassent la curiosité :
- Reproduire un résultat : rejouer un rapport ou un entraînement de modèle sur l'état exact des données utilisé à l'époque.
- Auditer : retrouver qui a changé quoi et quand, via l'historique des snapshots et leurs résumés d'opération.
- Revenir en arrière après un chargement défectueux, sans restauration de sauvegarde.
- Valider avant publication : écrire sur une branche d'audit, contrôler la qualité, puis publier.
- Figer un état de référence avec un tag (clôture mensuelle, jeu de données d'entraînement).
Attention à un détail documenté : une requête sur un timestamp, un snapshot ou un tag utilise le schéma du snapshot, alors qu'une requête sur une branche utilise le schéma courant de la table 3. Et l'historique a un coût : la durée de conservation des snapshots doit être fixée en fonction des besoins d'audit et des contraintes de protection des données, car une ligne supprimée reste lisible dans les anciens snapshots tant qu'ils n'ont pas expiré.
Le catalogue REST Iceberg : la vraie clé de l'interopérabilité
Le format de fichier ne suffit pas : il faut qu'un service dise à chaque moteur quel fichier de métadonnées est courant pour chaque table, et qu'il arbitre les commits. Historiquement, chaque écosystème avait son catalogue. Le projet Iceberg publie une spécification OpenAPI du catalogue REST, qui couvre la configuration, les espaces de noms, les tables (création, enregistrement, commit), les transactions multi-tables et même la planification des scans côté serveur 4.
L'intérêt est double. D'abord, un moteur compatible REST peut se brancher sur n'importe quel catalogue qui implémente la spécification, sans connecteur propriétaire. Ensuite, le catalogue devient le point unique où appliquer les droits d'accès. Polaris illustre cette approche : catalogue ouvert, neutre vis-à-vis des éditeurs, avec contrôle d'accès fin et support multi-cloud parmi ses axes de développement 5.
Ce point est central pour la souveraineté : en séparant catalogue, stockage et moteurs, une organisation peut garder la maîtrise de ses métadonnées et de ses données dans l'infrastructure de son choix, tout en utilisant des moteurs de plusieurs fournisseurs.
Ce qu'apporte la version 3 de la spécification
La version 3 du format étend les types (variant pour les données semi-structurées, géométrie et géographie, horodatages à la nanoseconde), ajoute les valeurs par défaut de colonnes, le lignage de lignes, les vecteurs de suppression binaires et les clés de chiffrement de table 1. Les vecteurs de suppression visent à rendre les mises à jour et suppressions plus efficaces ; le lignage de lignes sert notamment à la capture de changements 6. Une version 4, qui restructure les métadonnées, est en cours de développement et n'est pas adoptée à la date de rédaction 1.
Le support de la v3 progresse moteur par moteur, et parfois de façon partielle : chez Snowflake, la lecture par des moteurs externes des tables v3 gérées par Snowflake via son catalogue REST est disponible, mais pas encore l'écriture 6. Passer une table en v3 sans vérifier tous ses lecteurs et écrivains est le meilleur moyen de casser un usage.
Pour les tables existantes, la question de la migration se pose rarement en une fois. Une stratégie raisonnable consiste à créer directement en Iceberg les nouvelles tables et les nouveaux flux, puis à convertir les tables historiques par domaine, en commençant par celles qui bénéficient le plus de l'évolution de schéma ou du time travel. Chaque conversion doit être suivie d'une comparaison des résultats entre l'ancienne et la nouvelle table, et d'un test de lecture depuis tous les moteurs consommateurs. Enfin, la montée de version de format d'une table (de v2 vers v3 par exemple) doit être traitée comme un changement d'interface : annoncée, testée, et réalisée seulement quand tous les consommateurs sont prêts.
Checklist avant d'adopter Apache Iceberg comme standard
- Recenser tous les moteurs qui liront ou écriront les tables, avec leur niveau de support de la version de format visée (v2 ou v3).
- Choisir le catalogue et son mode d'exploitation (géré, ouvert auto-hébergé), et vérifier son support du protocole REST.
- Définir les règles de maintenance : compactage, expiration des snapshots, suppression des fichiers orphelins, et qui les exécute.
- Fixer la durée de rétention de l'historique en accord avec le DPO et les exigences d'audit.
- Limiter les moteurs autorisés à écrire sur chaque table, pour réduire les conflits de commit.
- Tester la réversibilité : lire une table de production depuis un second moteur et un second catalogue.
- Centraliser les droits d'accès dans le catalogue plutôt que dans chaque moteur.
Conclusion
Apache Iceberg s'impose moins par une fonctionnalité spectaculaire que par une combinaison de choix de conception solides : identifiants de colonnes, snapshots atomiques, partitionnement caché et catalogue REST standardisé. Ensemble, ils rendent la table indépendante du moteur. Reste à l'exploiter comme une infrastructure critique, avec sa maintenance et sa gouvernance. DATASWING aide les équipes à cadrer ces choix de format et de catalogue au regard de leurs contraintes d'interopérabilité et de souveraineté.
— Questions fréquentes
Ce qu'on nous demande souvent
Qu'est-ce qu'Apache Iceberg en termes simples ?+
Apache Iceberg est un format de table ouvert : une spécification qui décrit comment organiser des fichiers de données et leurs métadonnées pour qu'ils se comportent comme une table de base de données, avec transactions, évolution de schéma et historique. Plusieurs moteurs (Spark, Trino, Flink, entrepôts cloud) peuvent ainsi lire et écrire les mêmes tables sans copie.
À quoi sert le catalogue REST d'Iceberg ?+
Le catalogue REST est une API standardisée qui indique à chaque moteur quelle version de métadonnées est courante pour chaque table et qui arbitre les écritures. Comme la spécification est publique, un moteur compatible peut se connecter à n'importe quel catalogue qui l'implémente, ce qui réduit la dépendance à un éditeur et centralise la gestion des droits.
Comment faire du time travel sur une table Iceberg ?+
En Spark SQL, on ajoute TIMESTAMP AS OF suivi d'une date, ou VERSION AS OF suivi d'un identifiant de snapshot, d'une branche ou d'un tag. Cela fonctionne tant que les snapshots visés n'ont pas expiré. Les tables de métadonnées history et snapshots permettent de retrouver les identifiants et les opérations passées.
Faut-il passer ses tables Iceberg en version 3 ?+
Pas sans vérification préalable. La v3 apporte des types nouveaux, les vecteurs de suppression et le lignage de lignes, mais le support varie selon les moteurs et peut être partiel, par exemple en lecture seule. Il faut d'abord valider que tous les lecteurs et écrivains d'une table supportent la v3 et les fonctionnalités activées.
— Sources
Références citées
Les textes réglementaires et documentations évoluent : vérifiez la version en vigueur avant toute décision. Cet article n'est pas un avis juridique.
-
[1]
Iceberg Table Spec (format/spec.md) ↗Apache Software Foundation (dépôt apache/iceberg) · 2026
-
[2]
Evolution (docs/evolution.md) ↗Apache Software Foundation (dépôt apache/iceberg) · 2026
-
[3]
Spark Queries (docs/spark-queries.md) ↗Apache Software Foundation (dépôt apache/iceberg) · 2026
-
[4]
Apache Iceberg REST Catalog API (rest-catalog-open-api.yaml) ↗Apache Software Foundation (dépôt apache/iceberg) · 2026
-
[5]
Apache Polaris Graduates to Top-Level Project ↗Apache Polaris / Apache Software Foundation · 2026-02
-
[6]
May 7, 2026: Support for Apache Iceberg version 3 (General availability) ↗Snowflake (documentation officielle) · 2026-05
-
[7]
Working with Amazon S3 Tables and table buckets ↗Amazon Web Services · 2026